AI 相機真正的價值,不是「看見」而是「理解事件」
AI 相機真正的產品價值,不只是辨識人、車或動物,而是把連續影像轉成少量可信、可驗證、可觸發行動的事件。本文從事件規則、誤報、Edge AI、metadata interoperability 與 VLM 分析下一代智慧相機的系統架構。
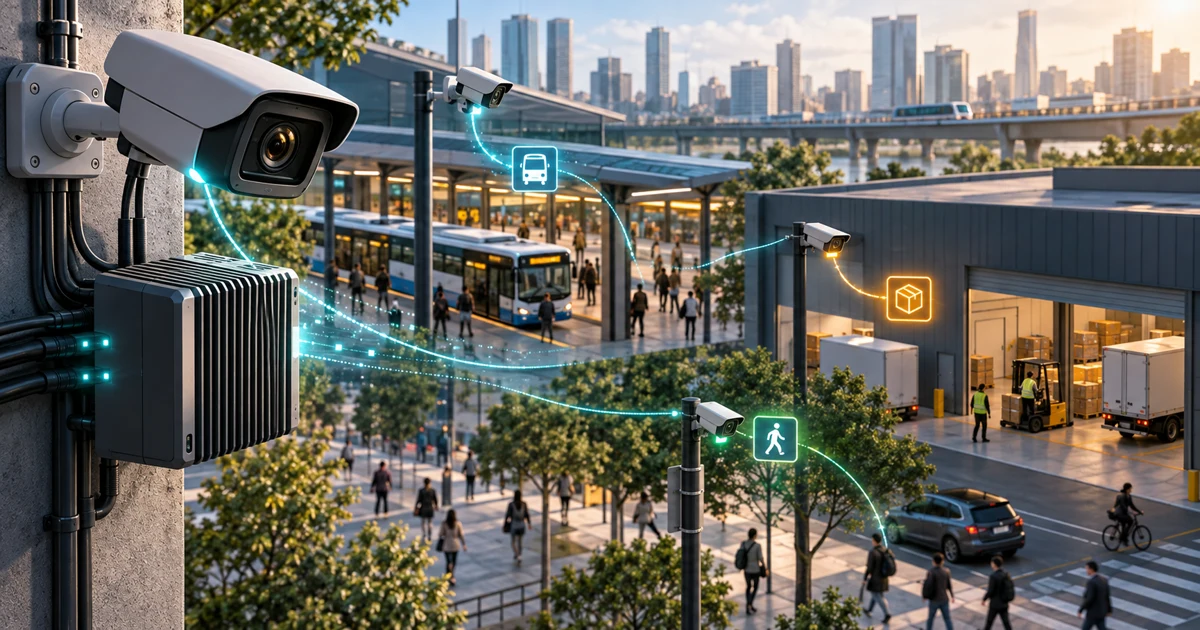
一支相機如果已經能辨識人、車、動物,卻還是每天送出大量沒有意義的通知,那它其實只是在傳統攝影機上多放了一個分類器。
它看見了更多東西,卻還沒有真正理解什麼值得注意。
我上一篇談 Computer Vision 如何從物件辨識走向場景與事件理解,重點放在視覺 AI 的能力演進。這一篇刻意往產品與系統層再走一步,不重講「模型如何看懂畫面」,而是問一個更實際的問題:
當相機已經可以 detect 人、車與物體之後,什麼才決定一個 AI camera 到底好不好用?
我的答案是:真正的產品單位,正在從 frame 與 object 變成 event。
一張影像、一個 bounding box,甚至一次分類結果,都不是使用者真正要的東西。使用者真正要的是「有一件值得處理的事情發生了」。
這個差異看起來很小,卻會重寫智慧相機的整套產品架構。
物件辨識只回答「有什麼」,事件才回答「發生了什麼」
傳統 vision model 很擅長把影像拆成物件:這裡有人、那裡有車、另一邊有一隻動物。
但產品需求通常不是這樣描述的。
保全系統真正想知道的,可能不是「畫面裡有人」,而是「有人在非開放時間進入限制區域,而且停留超過允許時間」。
交通系統真正想知道的,也不只是「有一台車」,而是「這台車正在錯誤方向行駛」、「某個區域的車流狀態超過設定條件」,或「多個物件正在形成需要關注的關係」。
戶外監測更不是看到任何移動物體就值得送出通知,而是要判斷進入的是什麼、發生在哪裡、持續多久,以及這件事是否值得留下影像或喚醒後續系統。
這也是為什麼今天實際部署的 video analytics,早就不只做 object detection。
以 Axis 的 Object Analytics 為例,現行系統可以設定 object in area、line crossing、time in area、occupancy、tailgating 等不同 scenario。NVIDIA DeepStream 9.1 的 nvdsanalytics 也提供 ROI filtering、overcrowding、direction detection 與 line crossing;其中 direction detection 與 line crossing 明確需要 tracker id 與歷史狀態,因為單一 frame 本身不足以判斷方向與跨越行為。
這指出一個很重要的工程事實:
事件不是「更準的物件辨識」。
事件通常至少需要物件、空間、時間、狀態與規則一起成立。
我會把這件事稱為 event contract,也就是系統事先定義「什麼條件成立時,才算一件值得被處理的事情」。
真正困難的不是偵測,而是把世界壓縮成少量可信事件
攝影機面對的是連續世界。
世界不會因為系統沒有興趣就停止變化。樹葉會晃、車燈會掃過、雨會落下、影子會移動、昆蟲會靠近鏡頭、物件會被遮擋,光線也會不斷改變。
一個實際產品不可能把所有變化都當成事件。
這也是為什麼 false alarm 不是智慧相機的小問題,而是產品架構的核心問題。
Axis 的 Object Analytics manual 很具體地提供 short-lived objects、swaying objects 與 small objects 等 filter,用來降低短暫物體、晃動植被或小型物體造成的不必要觸發。Axis 的 radar-video fusion camera 文件更直接呈現一個典型 trade-off:降低 detection sensitivity、要求 radar 與 camera 都確認物件,可以降低 false alarm 風險,但同時也會提高 missed detection 的風險。
這不是哪一個模型 benchmark 能單獨解決的問題。
它其實是在選 operating point。
我會把這個問題再往產品層翻譯成一個「false-alarm budget」:一套系統每天、每個場域、每一種事件,到底能容忍多少錯誤提醒,才不會讓使用者失去信任?
這不是一個業界正式標準名詞,而是我用來理解產品設計取捨的方式。
因為對使用者來說,一個系統如果「偶爾漏掉一個低風險事件」和「每天提醒大量不重要事件」,產品感受完全不同;但在高風險安全場景,漏報的代價又可能遠高於誤報。
所以真正需要設計的不是單一 accuracy,而是 false positive、false negative、事件嚴重度、人工複查成本與自動 action 風險之間的整體平衡。
警報一旦失去可信度,使用者就會開始忽略它。當這種系統再接上自動錄影、門禁、工業設備、無人機或其他 physical action 時,錯誤事件的成本又會被進一步放大。
因此我認為 AI camera 的核心 KPI 不應只盯著 object detection accuracy。
真正應該被問的是:這套系統最後產生的 event,有多少值得人或其他系統採取行動?
這是一個比「模型看得準不準」更接近產品價值的問題。
Event understanding 至少有三層,不是一個模型就解決
現在談 AI camera,很容易產生另一個錯覺:只要把更大的 Vision Language Model 接上攝影機,事件理解自然就會解決。
我不認為會這麼簡單。
比較合理的架構反而可能是分層的。
第一層仍然是 perception。它負責偵測、分類、tracking、segmentation,快速回答「畫面中有哪些東西,它們在哪裡」。
第二層是 state 與 event logic。它把跨 frame 的位置、時間、方向、區域、持續時間與規則串起來,回答「條件是否成立」。
第三層才是較高階的 semantic reasoning。當固定規則已經不足以描述事件,例如要判斷一段較複雜的操作流程、人物與物件之間的關係,或用自然語言搜尋「所有可能需要人工複查的異常情境」,VLM、LLM 與 video agent 才開始展現新的價值。
NVIDIA 目前的 Metropolis Video Search and Summarization,也呈現出這種分層方向。2026 年的 VSS 3 文件把系統拆成 real-time vision microservices、VLM-based analytics、video embeddings、downstream behavior analysis、alert verification,以及 video search、summarization 與 Q&A 等 agentic workflow。NVIDIA 在 VSS 2.4 的技術文章中,也把 Event Reviewer 描述成既有 computer vision pipeline 的上層 add-on,用來對低延遲警報做更高階的 VLM 分析。
到 2026 年 7 月,NVIDIA 進一步把 video agent 與企業 workflow 串接,讓分析結果可以進入結構化報告、ticket queue 與 escalation path。這個方向很值得注意,因為它把 video understanding 的價值從「回答影片裡有什麼」推向「這個事件接下來應該交給誰處理」。
但這不代表前兩層會消失。
相反地,我認為可靠的產品更可能把便宜、快速、可預測、容易測試的 detection 與 rules 留在前面,再把真正模糊、複雜、需要上下文的少數候選事件交給更大的模型。
這樣的架構比「每一個 frame 都丟給最大模型」更符合真實產品的延遲、算力、頻寬與成本限制,也和我前一篇談的 Edge AI 與 local/cloud routing 是同一條技術脈絡。
Edge AI 的角色不是消滅雲端,而是先決定什麼值得送出去
Arm 在 2026 年 6 月的 developer Code Along 中,用 Raspberry Pi 示範 local AI smart camera:直接從 live camera input 做 object detection,再讓偵測結果驅動 application decisions。
這個案例的重要性不在 Raspberry Pi 本身,而在架構。
當 camera 端或附近的 edge device 已經可以先做 perception 與初步 event filtering,系統就不必把每一段原始影像都同等送往遠端處理。
比較成熟的 camera pipeline 可能長成這樣:
camera / ISP → detector / tracker → event state → local filter → selected clip / metadata → semantic reasoning → action
前面幾層負責把連續世界壓縮成候選事件;後面幾層才負責解釋、確認與採取行動。
對戶外或遠端設備而言,這尤其重要。Arm 的 Computer Vision 資源也把 AI-powered trail camera 列為 edge object detection 的實際案例。這類產品真正需要解決的不是「相機能不能拍到東西」,而是有限的電力、連線與儲存應該花在哪些事件上。
這裡的關鍵不是 local 一定優於 cloud,而是讓不同工作落在適合的位置。
快速且頻繁的偵測留在近端,少量需要語意與長 context 的事件升級到較強模型,才比較像可長期維護的產品架構。
但我也要補一句:edge processing 不等於自動獲得 privacy。
即使推理發生在裝置端,系統仍然必須回答影像保留多久、metadata 是否上傳、誰可以存取、模型更新是否安全、事件資料是否足以重新識別個體等問題。Local-first 是架構選擇,不是隱私保證書。
當產品單位變成 event,metadata interoperability 反而更重要
如果 AI 相機最後只輸出影片,那不同廠牌之間最重要的相容性主要是 video stream。
但當相機開始輸出「事件」,事情就變了。
一個 event 需要帶著時間、物件類型、位置、規則、confidence、狀態或其他 metadata,才能被 VMS、NVR、cloud service、IoT platform 或其他設備理解。
這也是 ONVIF Profile M 值得注意的原因。
Profile M 的重點不是提高影像品質,而是標準化 analytics metadata 與 event handling。它支援 metadata streaming、generic object classification、部分特定物件 metadata、事件介面與 rule configuration;若產品支援 MQTT,也可以用標準化事件介面把分析結果送進 IoT 系統。
這透露另一個我認為很容易被忽略的產品問題:
AI camera 的價值不只在「相機裡面的模型有多強」,還在於它產生的事件能不能離開這台相機,進入一個更大的系統。
如果每一家廠商都用自己的 event schema、自己的規則語意、自己的 metadata format,那麼 AI camera 越聰明,系統整合反而可能越複雜。
所以 event understanding 的下一階段,不只是一場 model competition,也會是一場 interface competition。
真正可擴張的 Physical AI 基礎設施,需要的不只是看懂世界,還要讓不同系統對「發生了什麼」有可交換的表示方式。
VLM 會讓事件規則變得更開放,但目前不能假設它已經可靠
固定 event rule 的優點是清楚。
「車輛跨過這條線」、「有人停留超過設定時間」、「區域內物件數量超過門檻」,這些條件雖然有限,卻可以被明確測試。
VLM 帶來的下一步,是讓 camera system 可以理解比較開放的語意問題。
例如,不再事先寫死每一種危險行為,而是詢問:「這段作業流程中是否出現需要人工複查的操作?」或「找出所有可能偏離標準流程的事件。」
這會大幅提高 camera system 的可程式化程度。
但最新研究也提醒我們,不要太快把「能描述影片」等同於「真正理解事件」。
CVPR 2026 Findings 的 V-STaR benchmark 專門測試 Video-LLM 的 spatio-temporal reasoning。研究團隊評估 16 個當時的 Video-LLM,發現模型在「what」類問題上可能表現不錯,卻仍會在「when、where,再推到 what」的時空推理鏈上出現明顯落差;研究也指出模型可能依賴較靜態的 representation,而不是真正掌握動態過程。
這對 AI camera 是很關鍵的限制。
因為事件判斷最不能省略的,往往正是 where 與 when。
所以我對近期產品架構的判斷不是「VLM 取代 detector、tracker 與 rules」,而是 VLM 逐漸成為 event pipeline 的上層 reviewer 與 semantic reasoning layer。
至少在高風險場景裡,讓語意模型直接從 raw video 一步跳到自動 action,我認為仍然需要非常謹慎。
這不是說 VLM 不夠有用,而是可用性與可控性是兩個不同問題。
我認為下一代智慧相機真正競爭的是「事件品質」
如果把今天相機市場再往前推幾年,我不認為最大的差異會只剩解析度、sensor size 或單一模型 benchmark。
這些仍然重要,但會逐漸變成底層條件。
更高一層的產品差異,可能來自誰能建立更好的 event pipeline。
也就是:誰能在正確時間保留正確資訊、抑制沒有價值的觸發、維持足夠的上下文,必要時升級到更強的模型,再把結果交給正確的人或系統。
這裡真正有價值的不是「AI 看見了什麼」,而是「AI 認為什麼值得改變系統狀態」。
這也是我覺得 AI camera 和一般 cloud AI 最不一樣的地方。
一個 chatbot 回答錯誤,通常還停留在資訊層。
一個 camera event 一旦接上錄影、警報、門禁、交通控制、無人機或其他自動設備,它就開始成為 Physical AI 的感知入口。
因此相機裡真正需要被設計的,不只有 vision model,還包括 event contract、confidence、memory、escalation、retention、interoperability 與 action policy。
從產品角度看,我甚至會把未來智慧相機重新定義成一種「事件編譯器」。
它持續讀取真實世界,卻不是把世界全部上傳,而是把連續、混亂、充滿雜訊的現實,轉譯成少量可以被軟體與人理解的事件。
當這件事做得夠好,相機才真正從「會看」走向「有用」。
接下來值得觀察什麼
我接下來最關注的不是哪一家又宣稱辨識率提高,而是幾個更接近系統成熟度的訊號。
第一,VLM 能否穩定處理長時間、跨鏡頭與需要時空推理的事件,而不是只對短片段做漂亮描述。
第二,edge device 能否用合理功耗做更高階的語意篩選,讓更多原始影像不必離開現場。
第三,event verification 是否開始成為標準 pipeline,而不是直接把 detector output 當成 action。
第四,事件 metadata 的互通性是否持續改善,讓相機、VMS、cloud 與 IoT 系統不必被單一廠商格式綁住。
第五,產品是否能把自動 action 的責任邊界設計得足夠清楚。
我的預測是,智慧相機下一階段的競爭會逐漸從 image quality 與 object accuracy,往 event quality、interoperability 與 action reliability 移動。
這是預測,不是已發生的市場結論。
真正能驗證這個判斷的訊號,是主要 camera、VMS 與 edge AI platform 是否持續把產品重心從「辨識更多類別」,轉向 event verification、跨鏡頭 context、自然語言規則、標準化 metadata 與可靠的 action workflow。
這不是說攝影機不再重要,而是攝影機正在從「記錄世界的裝置」,變成「持續解讀世界狀態的節點」。
而當這些節點大量存在於道路、工廠、商場、戶外環境與家庭裡,AI camera 就不再只是 camera 產品類別,而會成為 Physical AI 基礎設施的一部分。
常見問題
AI 相機和一般智慧相機有什麼差別?
「智慧相機」並沒有單一統一標準。實務上,差異通常在於裝置是否具備本地或遠端的 computer vision inference,以及能否把影像轉成物件、狀態或事件。本文所說的 AI 相機特別強調 event pipeline,而不只是提供錄影與遠端觀看。
為什麼 object detection 準確率高,還是可能一直誤報?
因為 object detection 只確認「看到了什麼」,警報通常還需要空間、時間、方向、持續時間與情境規則。物件辨識正確,不代表事件判斷一定有價值;產品還必須在 false positive 與 missed detection 之間選擇適合場景的 operating point。
AI 相機一定要連雲端嗎?
不一定。今天已經有 edge-based video analytics 可以在相機或附近設備上完成 detection、tracking 與 event filtering。較複雜的 semantic reasoning、跨攝影機查詢或長時間影片理解,則可能再交給較強的 edge server 或 cloud model。實際架構取決於 latency、power、bandwidth、privacy、成本與可靠性要求。
VLM 會取代傳統 computer vision model 嗎?
短期內我不認為會全面取代。VLM 擅長較開放的語意理解,但 detector、tracker 與明確 event rule 仍具有速度、成本與可測試性優勢。較合理的方向是多層模型協作。
ONVIF Profile M 和 AI 相機有什麼關係?
Profile M 處理的是 analytics metadata 與 events 的互通,而不是提升模型本身的辨識能力。當智慧相機開始輸出 object metadata、counting event、rule trigger 或 MQTT event,標準化介面會影響它能否和 VMS、cloud service 與 IoT 系統組成開放架構。
在裝置端做 AI 就一定比較保護隱私嗎?
不一定。On-device inference 可以減少部分原始影像傳輸需求,但隱私仍取決於資料保存、metadata、權限、模型更新、加密與產品治理設計。Edge AI 能提供更好的架構條件,不代表風險自動消失。
來源與延伸閱讀
- AXIS Object Analytics User Manual
- AXIS Object Analytics
- AXIS Q1656-DLE Radar-Video Fusion Camera
- NVIDIA DeepStream 9.1: Gst-nvdsanalytics
- NVIDIA Blueprint for Video Search and Summarization 3
- NVIDIA: How to Integrate Computer Vision Pipelines with Generative AI and Reasoning
- NVIDIA: Integrating Context-Aware Video AI Agents Into Enterprise Workflows
- Arm Code Along: Edge AI 101, Build a Local AI Smart Camera with Raspberry Pi
- Arm Computer Vision Development Resources
- ONVIF Profile M: Metadata and events for analytics applications
- CVPR 2026 Findings: V-STaR, Benchmarking Video-LLMs on Video Spatio-Temporal Reasoning