當 AI 有了眼睛:Computer Vision 會如何改變日常世界?
Computer Vision 正從辨識單張影像裡的物件,走向理解連續影像中的事件、關係與風險。真正重要的變化,不只是相機看得更準,而是視覺系統開始在邊緣端判斷什麼值得注意、保留與觸發行動。
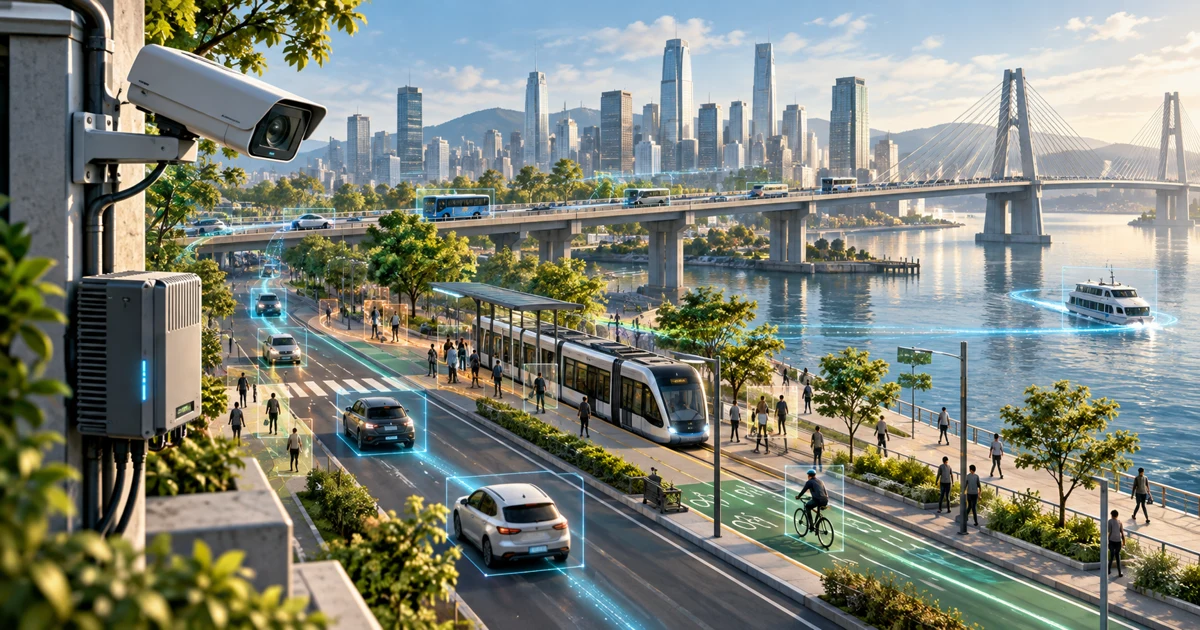
如果說大型語言模型讓 AI 開始能夠「讀」人類累積的文字,那 Computer Vision 做的事情,則更接近讓 AI 開始持續「看」這個世界。
但我認為真正值得注意的,不是相機又多辨識了幾種物體,也不是辨識率多提升了幾個百分點。
更大的變化是:視覺 AI 正從回答「畫面裡有什麼」,逐步走向回答「這裡正在發生什麼」。
這兩句話看起來只差一點,背後卻是完全不同的系統能力。
辨識出一個人、一台車、一隻狗,是 perception。判斷一台車是否正在逆向、一個包裹是否被遺留、一個路口是否形成危險衝突、一隻動物是否正在進入不該進入的區域,則開始需要時間、關係、上下文與規則。
當 AI 從辨識物體跨到理解事件,攝影機也就不再只是記錄設備,而開始變成 Physical AI 裡的一種感知節點。
這正是我認為 Computer Vision 下一階段最重要的轉折。
從「看見物體」到「理解事件」
傳統 Computer Vision 的典型任務,常被拆成 image classification、object detection、segmentation、pose estimation、tracking 等問題。
這些能力都非常重要,而且今天仍然是大量實際系統的基礎。例如一個 object detector 可以告訴系統:畫面裡有三個人、兩台車、一個交通號誌;tracker 則可以把同一個物體跨越不同 frame 的移動串起來。
但只做到這裡,系統仍然不知道「事情的意義」。
NVIDIA 對新一代 video analytics AI agents 的描述,就很清楚地反映這個轉變。傳統 video analytics 往往由針對特定目標設計的模型組成,而現在 vision-language models 與 generative AI 開始被加入影像分析流程,讓系統能用自然語言搜尋、摘要、解釋 live 或 archived video,並從較廣泛的上下文中推理。
Google Gemini 的 Video Understanding 文件也呈現類似方向:模型不只接受圖片,也可以處理影片,描述內容、回答影片相關問題、提取資訊,甚至引用特定時間點。
這代表 Computer Vision 的問題正在從:
「我能不能辨識這是一台腳踏車?」
逐漸轉成:
「這台腳踏車、這台右轉車輛與這名行人,在接下來幾秒是否正在形成危險關係?」
後者才真正接近日常世界裡需要的 intelligence。
相機真正會改變的,不是解析度,而是它開始有「事件模型」
過去談相機產品,很容易集中在 sensor size、解析度、鏡頭、低光表現、幀率與壓縮效率。
這些都不會消失。事實上,它們反而會繼續限制 AI 能看到什麼。
Arm 在 2026 年針對 low-light AI imaging 的研究就指出,改善低光影像品質也可能改善後續 object detection、scene understanding 與 decision-making 的視覺輸入。這提醒我們一件很工程化、卻很容易在 AI 討論裡被忽略的事情:模型再好,輸入品質仍然會決定上限。
但下一階段產品差異會多出另一層:event model。
也就是系統如何定義「什麼事情值得注意」。
例如,同一支相機可以被設定成:
在零售場域,只關心貨架缺貨、排隊長度突然增加,或某個區域出現異常停留。
在工廠裡,只關心設備區域是否有人進入、物件是否掉落、作業流程是否偏離安全條件。
在道路上,只關心逆向、違規停車、近距離衝突,或交通流量突然異常。
在戶外 trail camera 上,甚至可以只留下特定動物出現的片段,而不是把數百小時幾乎沒有事件的影片全部上傳。
Arm 目前的 Edge AI developer materials 就提供了 local AI smart camera 與 AI-powered trail camera 的案例,核心概念不是把每一張畫面送到雲端,而是在裝置附近先做 object detection,再讓偵測結果驅動應用決策。
所以我會把下一代智慧相機的價值重新定義成:
不是「拍得更多」,而是「更早知道哪一段值得被理解」。
Edge AI 會讓「看見」變成一種分散式能力
如果每一支攝影機都把原始影像二十四小時持續上傳到雲端,再由大型模型集中處理,理論上最簡單,實務上卻會很快遇到 bandwidth、latency、storage、privacy 與 operating cost。
這也是為什麼 Computer Vision 和 Edge AI 幾乎必然會一起發展。
Arm 的 Edge AI 平台定位就是讓 AI model 可以在 Cortex-M、Cortex-A 與 Ethos-U NPU 等低功耗或資源受限設備上執行 low-latency inference;NVIDIA 的 Metropolis 與 DeepStream 則提供從 edge、on-premises 到 cloud 的 streaming analytics 與 multi-camera pipeline。
這些架構指向一個很重要的設計選擇:不是所有影像都值得離開裝置。
一個比較合理的 vision system,可能會在 edge 端先完成幾件事:偵測物件、追蹤、過濾重複 frame、判斷事件是否成立,再決定要不要保留 clip、送出 metadata,或呼叫更大的 cloud model 做更深層推理。
我認為這一點會改變未來大量 camera-based products 的 architecture。
相機可能不再只是 camera + network connection,而會變成:
sensor → image signal processing → local perception → event filtering → selective upload → higher-level reasoning → action。
這其實已經和我上一篇談的 Physical AI 非常接近。差別只在於 Computer Vision 位在整個 Physical AI stack 的感知入口。
當入口本身開始具備推理與事件篩選能力,後面的系統就不必再把所有原始世界完整搬進 data center。
但「持續看懂世界」比單張圖片困難很多
Computer Vision 最近最容易讓人產生錯覺的地方,是大型 multimodal model 已經能非常漂亮地描述圖片與影片,因此我們很容易以為 video understanding 已經接近解決。
其實還差得很遠。
影片不是圖片的集合而已。
事件有順序、有持續時間、有因果關係,也有「還沒發生完,所以現在不能下結論」的情況。
2025 年 CVPR 的 OVO-Bench 專門測試 online video understanding,要求模型面對持續輸入的影片,在不同時間點做 backward tracing、real-time understanding 與 forward active responding。研究結果指出,即使當時較強的 Video-LLM 在傳統 video benchmark 上已有進展,面對真正的 online temporal reasoning 仍有明顯落差。
另一篇 CVPR 2025 對 Video-LLM temporal comprehension consistency 的研究,也發現模型對影片內容、提問方式與任務設定的變化仍然敏感,時間定位與回答的一致性並不穩定。
這些限制非常重要,因為真實世界事件常常就是時間問題。
一個人站在門口五秒,和站在門口四十分鐘,可能代表完全不同的事情。
一輛車靠近行人,若正在減速,和正在加速,風險也不同。
一個箱子停在地上,可能是剛被放下,也可能是被遺棄很久。
只看單張 frame,都可能得到錯誤結論。
所以真正的 Vision AI 不只是 spatial intelligence,也必須逐步建立 temporal intelligence。
多支攝影機之後,問題又變成「世界座標」
單支相機看懂一個場景已經不容易,多支相機共同理解一個空間更困難。
因為同一個人或物件進入另一支 camera 的視野後,角度、尺度、遮擋與光線都可能完全不同。
NVIDIA DeepStream 目前的 multi-view 3D tracking 技術就是一個很具體的工程例子。它要求多支攝影機先經過 calibration,再把不同視角中的偵測結果映射到共同座標系,並透過跨 camera 的 ID 與量測融合維持追蹤的一致性。
這件事的意義不只是「可以追得更準」。
它表示 Computer Vision 正開始從分析一張張畫面,走向建立 physical space 的持續 representation。
當道路、倉庫、商場、工廠甚至城市空間裡的多個 sensor 可以共同形成一致的環境狀態,視覺 AI 才真正開始具備「空間記憶」。
但同時,治理問題也會快速放大。
最大的問題不是 AI 看錯,而是誰定義「值得注意」
Computer Vision 最直觀的風險是 misclassification。
例如把人看成物體、把正常行為判斷成異常、漏掉真正的危險事件。
這些當然重要。
NIST 長期進行 Face Recognition Technology Evaluation,也持續顯示不同算法在 demographic groups、image quality 與使用情境下的 error patterns 可能不同。這代表我們不能把某一個 benchmark 上的平均 accuracy,直接當成所有真實環境裡都相同可靠。
但我認為更深一層的風險,不只是「模型有沒有看錯」,而是「系統被要求看什麼」。
假設一套 camera system 被設定為偵測「異常停留」。
那麼第一個問題不是 model accuracy,而是:停留多久算異常?在哪些區域算異常?哪些人被允許停留?誰決定 threshold?判斷之後會發生什麼?紀錄保留多久?能不能被拿去做第二種用途?
這些都不是純 Computer Vision 問題。
它們其實是 product design、policy 與 governance 問題。
這也是為什麼我不認為「全部改成 edge inference」就自然解決 privacy。
如果資料不離開裝置,確實可以降低某些資料傳輸與集中儲存風險。但如果裝置本身持續替人分類、推斷行為、建立身份關聯,隱私問題並沒有消失,只是從「誰擁有影像」變成「誰有權定義與使用視覺推論」。
未來真正成熟的 Vision AI,我認為需要一起設計四件事:perception accuracy、event definition、data minimization,以及 downstream action boundary。
少一個,系統都可能在技術上很強,卻在真實環境裡不可接受。
我真正關注的轉折:Camera 正從 recorder 變成 local observer
如果把這整條技術路線拉遠一點看,我認為 Computer Vision 的重要性不在於「AI 終於會看圖」。
真正的轉折是 camera 正從 recorder 變成 local observer。
Recorder 的工作是忠實保存影像,理解留給人。
Local observer 則開始在現場先判斷:發生了什麼、是否需要保存、是否要通知別的系統,以及是否值得呼叫更多算力。
這會讓日常世界裡大量原本沉默的 camera 與 optical sensors 變成 distributed intelligence nodes。
但我對這個方向的判斷並不是「未來所有相機都會變成超級 AI」。
更可能的情況,是能力高度分層。
很小的 edge device 只做 detection 與 filtering;更強的 local processor 做 tracking 與 event understanding;雲端模型才處理跨時間、跨 camera、需要語言與外部知識的複雜推理。
換句話說,未來 Computer Vision 的競爭不只在模型,而是在整個 perception stack 如何分工。
這個 stack 包括 camera sensor、ISP、edge compute、model、memory、network、cloud reasoning,以及最終的 action policy。
這也是為什麼 Computer Vision 是 Physical AI 很好的下一個入口。AI 一旦真正開始「看」,下一步自然就會問:它應該做什麼?
接下來值得觀察的四個訊號
第一,Video-Language Model 能不能從 offline video 走向穩定的 streaming understanding。
不是上傳一段影片後慢慢分析,而是在事件正在發生時就能維持時間脈絡、更新判斷,並知道什麼時候資訊還不足以回答。
第二,Edge AI 能不能把更高階的 vision reasoning 塞進合理的 power budget。
如果裝置端永遠只能做簡單 object detection,而所有理解仍要回到雲端,vision system 的 architecture 仍會受 network 與 cost 強烈限制。
第三,產業能不能建立比「accuracy」更完整的 evaluation。
真正重要的會包括 temporal consistency、false alarm rate、occlusion robustness、low-light performance、cross-camera identity consistency,以及不同環境與族群的 error distribution。
第四,也是我認為最容易被忽略的,是治理能不能跟上事件理解。
當 camera 不只是保存影像,而是替空間裡的人與行為貼上語意,誰能定義事件、誰能查詢、誰能覆核,以及系統能採取什麼 action,會變成比解析度更重要的產品規格。
常見問題
Computer Vision 和 Vision AI 是同一件事嗎?
兩個詞高度重疊。Computer Vision 是較成熟、範圍明確的研究與工程領域,涵蓋影像與影片中的辨識、偵測、分割、追蹤與理解;Vision AI 則常被產業用來泛指把這些能力與 deep learning、multimodal models、VLM、edge inference 等整合成應用系統。實務上需要看具體 architecture,而不是只看名稱。
Vision-Language Model 會取代傳統 object detection 嗎?
短期內不太可能全面取代。許多 real-time system 仍然需要速度快、成本低、行為可預測的 detector 與 tracker;VLM 更可能先被加入上層,用來處理較複雜的自然語言查詢、事件摘要與 contextual reasoning。兩者很可能長期共存。
為什麼 Computer Vision 特別需要 Edge AI?
影像資料量大,而且很多應用需要低延遲反應。Edge inference 可以先在資料產生的位置完成偵測、過濾與部分事件判斷,只把必要 metadata 或片段送往後端,降低 bandwidth 與 cloud dependency。但 edge 並不自動等於 privacy,資料用途與推論權限仍然需要治理。
相機越多,AI 就一定看得越準嗎?
不一定。更多 camera 可以增加視角,但也帶來 calibration、同步、identity matching、network latency、遮擋與 data fusion 等新問題。如果系統無法建立一致的座標與時間脈絡,多一支 camera 也可能只是多一份不一致的資料。
未來智慧相機最值得看的規格是什麼?
除了 sensor、低光與解析度,我會更關注 local inference capability、event model、false alarm rate、temporal understanding、可否離線運作、資料保留方式,以及觸發 action 前是否有足夠的 human override 與 auditability。這些規格比單純宣稱「支援 AI」更能反映產品成熟度。
來源與延伸閱讀
- NVIDIA Metropolis: visual AI agents and video analytics
- NVIDIA DeepStream SDK
- NVIDIA DeepStream: Multi-View 3D Tracking
- Google AI for Developers: Video understanding
- Arm Developer: Edge AI
- Arm Developer: Computer Vision
- Arm: Edge AI 101, local AI smart camera
- Arm Applied AI Research: Low-Light AI Imaging, NTIRE 2026
- CVPR 2025: OVO-Bench, online video understanding
- CVPR 2025: Consistency of Video-LLMs in temporal comprehension
- NIST: Face Recognition Technology Evaluation, demographic effects